日前,全球权威 AI 基准性能评估组织 MLCommons 正式发布最新 MLPerf Storage v3.0 测试结果。焱融科技携手忆恒创源,再次刷新多项性能纪录:
在 3D-UNet 模型测试中,三节点存储集群实现高达 544GiB/s 高带宽,再次刷新其在2025年创下的 478GiB/s 性能纪录;
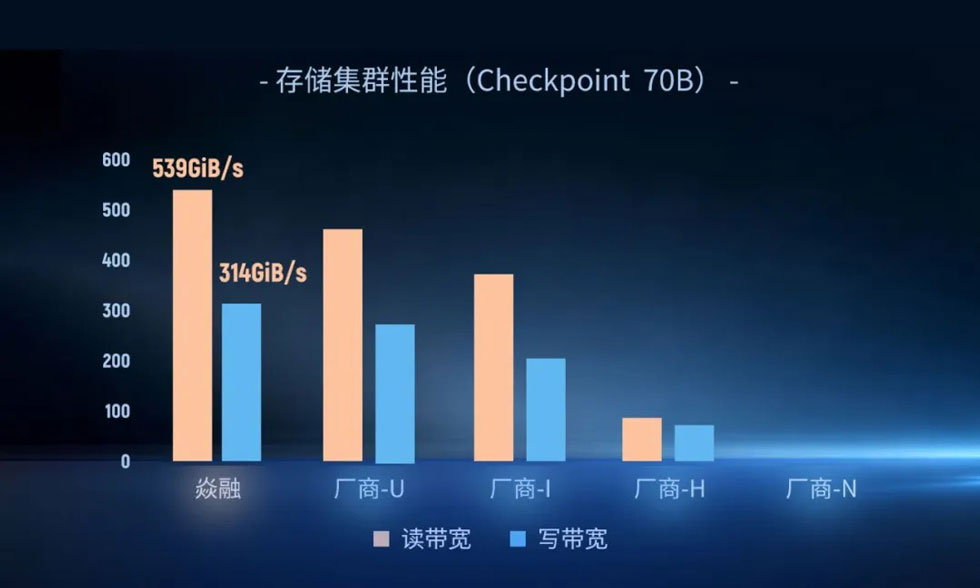
在 Checkpoint 70B 存取测试中,三节点存储集群实现 539GiB/s 的读带宽和 314GiB/s 的写带宽,读写性能均位居全球第一;
在 Llama3.1-70B KV Cache 存取测试中,实测读带宽 288GiB/s,写带宽 60GiB/s,每秒 Token 生成数量同样保持领先
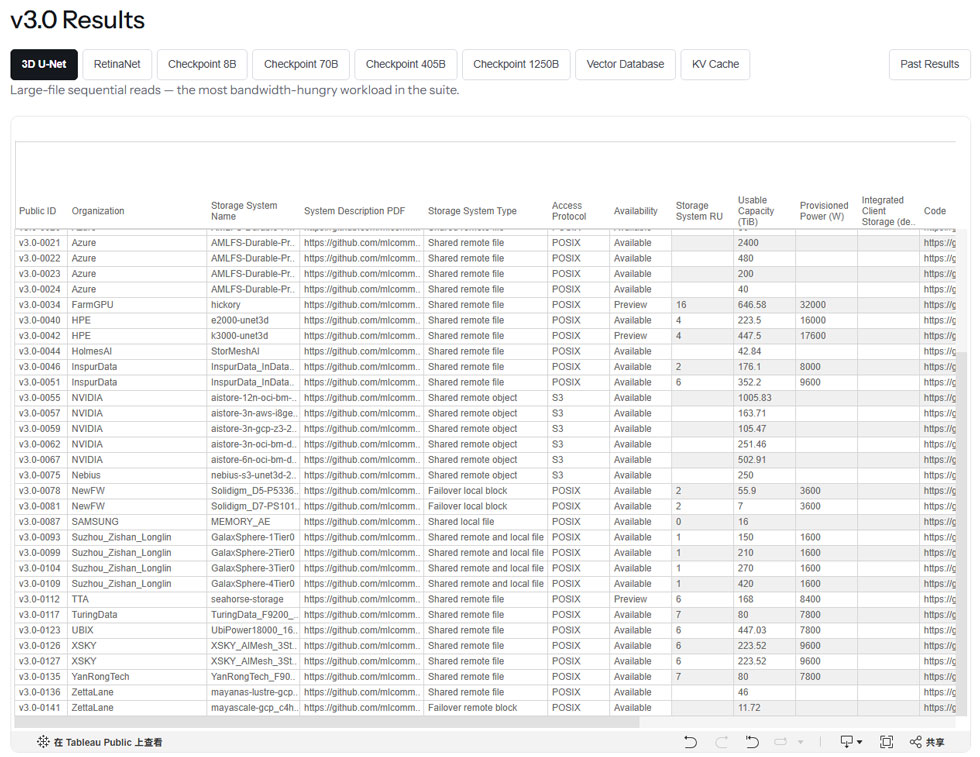
MLPerf Storage v3.0测试结果(引自MLCommons官网)
本次测试采用的硬件集群由3台焱融 F9000X 全闪存储节点和9台 x86 客户端服务器组成,依托 NVIDIA QM9700 交换机实现 NDR400 高速网络互联。每台 F9000X 存储节点采用 2U 通用 x86 服务器平台,搭载 Intel 至强 6900P 处理器、PBlaze7 系列 PCIe 5.0 SSD 以及4块 NVIDIA 400Gb 网卡,构建高带宽、低时延的全闪存储测试环境。
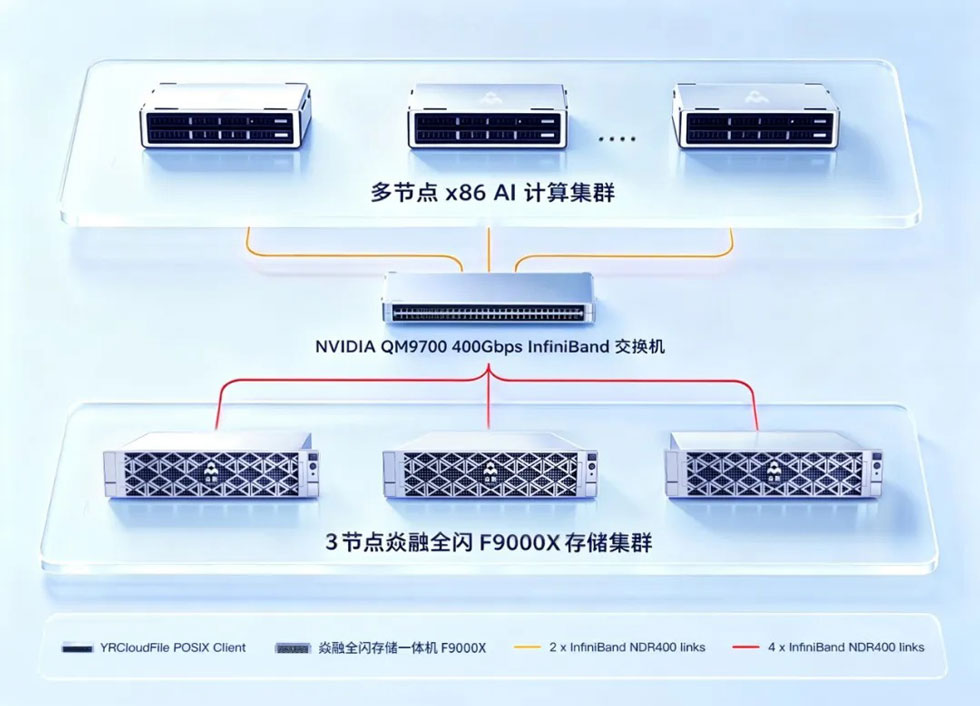
测试时使用的网络拓扑(引自焱融科技)
相较于 v2.0,MLPerf Storage v3.0 最大的变化,是增加了 AI 推理阶段 KV Cache 存取性能测试环节:在大模型推理服务中,庞大的 KV Cache 极其消耗显存资源,新兴架构通常将非活跃会话的 KV Cache 卸载至存储系统,待会话激活时再重新加载,使得推理服务演变成典型的存储 IO 负载。
MLPerf Storage v3.0 通过模拟对话、代码编写及长文档分析等场景下的 KV Cache 卸载与重载,量化存储对推理集群并发上限及响应延迟的影响。为确保结果的严谨与公正,v3.0 同样要求每项基准测试必须多次重复执行并最终选取平均值。
在 3D U-Net 模型训练测试中,F9000X 三节点全闪存储集群实现 544GiB/s(约合 584GB/s)的聚合带宽,位居该场景全球第一,较此前 2025 年公开测试成绩更进一步,展现了高强度 AI 训练负载下的高带宽输出能力,为大规模 AI 训练提供高效的数据供给。
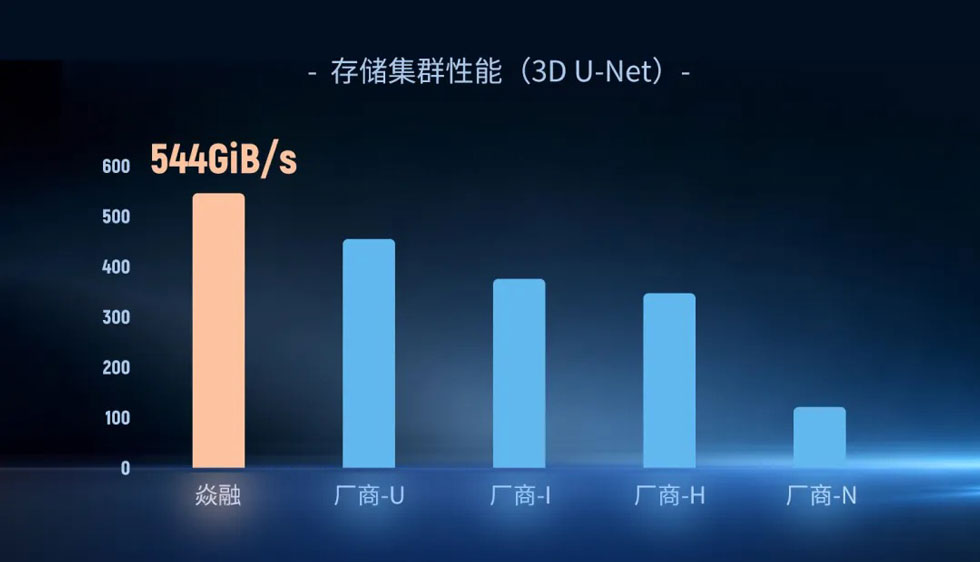
3D U-Net 测试结果(引自焱融科技)
在 Checkpoint 70B 测试中,F9000X 三节点全闪存储集群实现 539GiB/s(约合 578GB/s)读带宽和 314GiB/s(约合 337GB/s)写带宽,可有效缩短大模型训练过程中 Checkpoint 的存档与恢复时间,减少训练中断带来的算力与时间损耗,提升大规模模型训练的连续性。
针对 MLPerf Storage v3.0 新增的 Llama3.1-70B KV Cache 存取测试,F9000X 三节点全闪存储集群实现 288GiB/s(约合 309 GB/s)读带宽和 60GiB/s(约合 64GB/s)写带宽,相同存储部署规模下,其每秒 Token 生成数量同样保持领先,充分验证了其在大模型推理场景下处理 KV Cache 高并发卸载与回读的能力,为长上下文、高并发推理提供高效的存储 I/O 支撑。
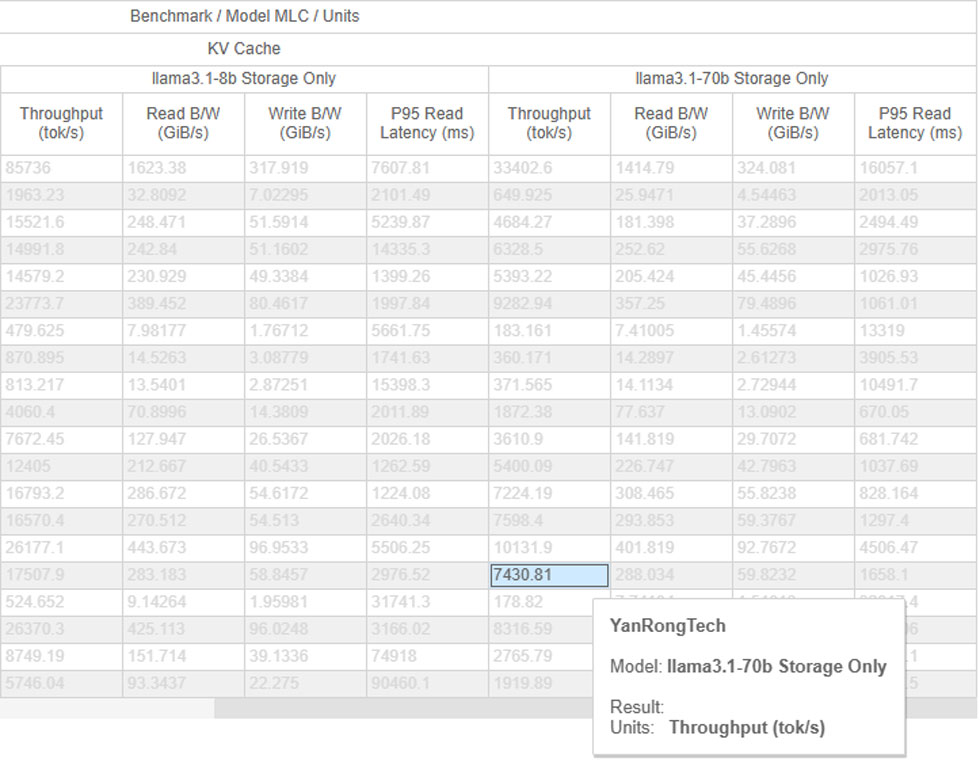
KV Cache llama3.1-70b 测试结果(引自MLCommons官网)
从大模型的高效训练到长上下文的实时推理,存储系统已成为释放 AI 算力潜能的关键钥匙。本次在 MLPerf Storage v3.0 测试中取得的卓越成绩,不仅证明了焱融科技 YRCloudFile 分布式存储与忆恒创源 PBlaze7 系列 PCIe 5.0 SSD 在软硬件结合上的极致效能,也再次树立了国产软硬件协同创新在全球 AI 存储领域的性能标杆。
未来,忆恒创源将继续秉持开放合作的态度,深化与智算生态伙伴的技术协同,以高性能、低延迟、高可靠的企业级存储产品,为 AI 大模型及前沿算力基础设施建设筑牢扎实的存力底座,加速 AI 技术的产业化落地。


